“인식·경우의 수 탐색 넘어
추론과 기억하는 AI 목표
20억건 데이터 기반 연구
오픈소스 활용 협력 필요”
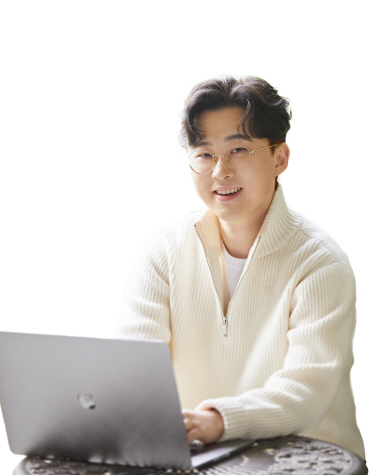
김일두(사진) 카카오브레인 대표는 20일 “초거대 인공지능(AI) 발전에는 다양한 기업의 협력이 필요하다”며 “앞으로 글로벌 최대 규모의 ‘이미지 텍스트 멀티모달(multi-modal) 데이터셋(이미지와 텍스트를 동시에 이해하는 멀티 모델 데이터 집합체)’을 구축해 공개하겠다”고 말했다. 주요 정보기술(IT) 기업들의 초거대 AI 개발 경쟁이 본격화하고 있지만, 오픈소스를 활용해 더 많은 파트너사가 참여해 협력과 개발의 ‘유대감’을 형성해야만 더 큰 발전을 기대할 수 있다는 의미다.
김 대표는 이날 오전 온라인 기자간담회를 열고 “AI는 인식과 경우의 수, 추론의 관점에서 볼 수 있는데 지금은 인식과 경우의 수 영역이 우리가 잘 풀 수 있는 부분이고, 이 부분에서 많은 문제를 제기해야 한다”며 이같이 밝혔다. 김 대표는 올해 33세로 2012년 카카오 소프트웨어 엔지니어로 입사해 컴퓨터 비전, 데이터 증강기술, 의료진단 등 AI 기술을 연구했고 3년 동안 국제학회에 10편의 논문을 실은 AI 분야의 소장 실력파다. 지난 4월 파격적으로 대표에 발탁됐다.
김 대표는 “카카오브레인은 차별화된 연구 및 기술을 선도하면서 인식, 경우의 수 탐색을 넘어 추론과 기억, 사람 같은 AI를 향해 도전하고 이 기술들이 세상의 중요한 문제에 쓰이도록 하겠다”며 “카카오브레인은 정제를 거친 20억 건 수준의 이미지-텍스트 데이터를 기반으로 사람 같은 AI를 실현할 수 있도록 연구하고 있다”고 설명했다. 그는 또 이를 일부 공개해 AI 산업 전반에 기여할 수 있는 방안도 검토하고 있다고 덧붙였다.
김 대표는 특히 “언어모델은 챗봇뿐만 아니라 문서 검색, 요약, 분류 등 다양한 업무에 활용될 수 있다”며 “다양한 곳에서 모델의 문제점과 단점을 밝혀내고 이를 카카오브레인과 함께 해결하고 극복하기 위해 고민했으면 한다”고 밝혔다.
카카오브레인은 최근 초거대 AI 모델 ‘코지피티(KoGPT)’와 ‘민달리(minDALL-E)’를 오픈소스로 공개한 바 있다. 코지피티는 한국어를 사전적, 문맥적으로 이해하고 이용자가 원하는 결과 값을 보여주는 모델이다. 예컨대 영화 리뷰 댓글을 보고 댓글이 영화에 긍정적인지 부정적인지 판별할 수도 있고, 글의 내용을 짧게 요약하는 것도 가능하다. 민달리는 이용자가 텍스트로 명령어를 입력하면 실시간으로 원하는 이미지를 만들어주는 이미지 생성 모델이다. 1400만 장의 텍스트와 이미지 세트를 사전에 학습하고 13억 개의 파라미터(매개변수, 학습 데이터 저장소)를 가지고 있다.
이승주 기자 sj@munhwa.com


주요뉴스
이슈NOW
기사 추천
- 추천해요 0
- 좋아요 0
- 감동이에요 0
- 화나요 0
- 슬퍼요 0
